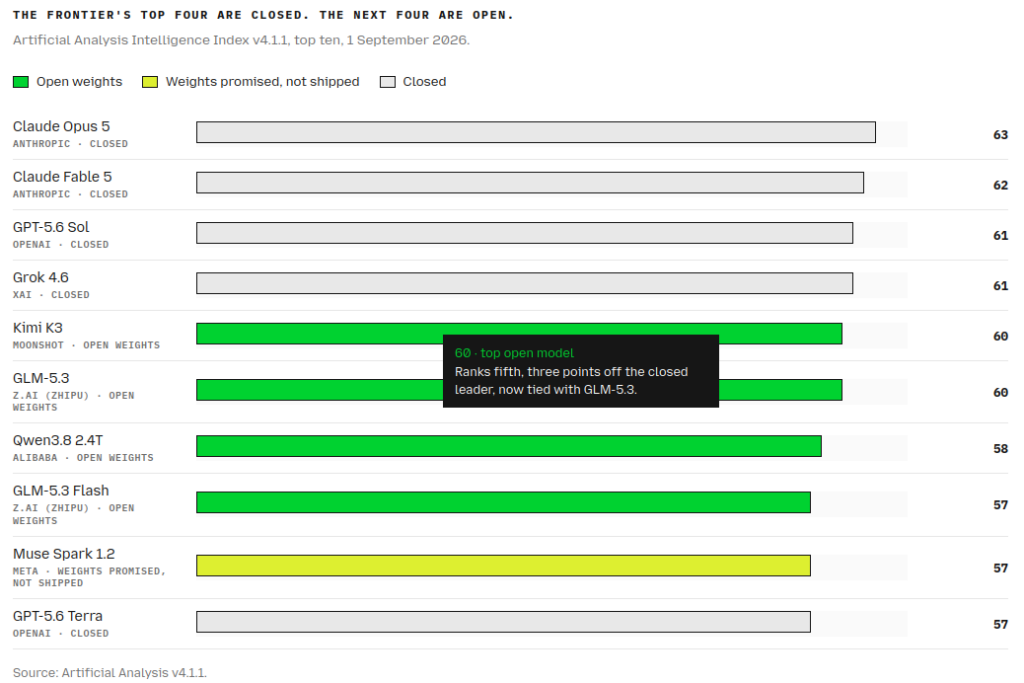
Mozilla a publié sa nouvelle édition State of Open Source AI : les modèles ouverts rivalisent désormais avec les systèmes propriétaires les plus avancés. Toutefois, ils déplacent l’intégralité des risques juridiques, cyber et éthiques sur les épaules de ceux qui les déploient.
Profitons-en pour faire un rapide retour sur les principaux points de rupture :
1. La clarification définitive de l’Open Source Initiative (OSI) 🏷️
La publication et l’adoption formelle de la définition de l’IA Open Source fixent enfin la frontière : l’immense majorité des modèles dits « ouverts » sont des modèles à poids ouverts (open weights). L’absence d’accès aux jeux de données complets d’entraînement ne permet pas la reproductibilité de la plupart des éléments utilisées lors de la production de ces modèles.
🚨 Risque de gouvernance : pour les DPO, l’incapacité à prouver la provenance exacte des flux d’entraînement interdit de fait le statut de conformité intrinsèque.
2. L’entrée en plein régime de l’AI Act européen 🇪🇺
Les exigences de transparence applicables aux modèles à usage général (GPAI) imposent un audit strict des données sous copyright et de l’architecture d’entraînement. L’exception open source prévue par le texte européen ne protège pas les organisations qui intègrent, modifient ou exposent ces modèles en interne.
🚦 Impact conformité : l’amende et l’injonction de retrait guettent les organisations incapables de fournir la documentation technique complète de leurs modèles tiers.
3. Souveraineté et hygiène de la supply chain logicielle 🛡️
Le déploiement sur infrastructure souveraine ou locale s’est généralisé pour garantir l’étanchéité face aux transferts de données hors UE. En contrepartie, les registres de modèles publics restent la cible d’attaques sophistiquées : backdoors injectées dans les tenseurs, attaques par empoisonnement et manipulation des contextes RAG.
🤖 Priorité cyber : l’audit systématique des poids, l’isolement en bac à sable et l’intégration d’une nomenclature SBOM dédiée au machine learning sont désormais indispensables avant toute mise en production.
4. Droit à l’oubli et consanguinité des données synthétiques 🗄️
Le recours massif aux données synthétiques et à la distillation de modèles frontières pose un double problème : dérive des biais initiaux et fragilité contractuelle vis-à-vis des licences d’origine. Sur le front du RGPD, la remédiation face aux demandes d’effacement (article 17) reste insoluble sans techniques d’oubli machine (machine unlearning), encore peu stabilisées à l’échelle industrielle.
L’accès ouvert aux modèles offre une autonomie stratégique incontestable, mais il transforme l’intégrateur en quasi-fabricant aux yeux du régulateur et des autorités de contrôle.
🔗 Source : https://stateofopensource.ai/